

RAG* для бизнеса: как выбрать архитектуру и оценить качество
Разбираем, что влияет на качество, скорость и стоимость ИИ-решения. Статья поможет понять, как устроена RAG-система, подходит ли она под ваши задачи и что учесть, чтобы сократить затраты на разработку.
В продажах, строительстве, производстве, промышленности и финансах сотрудники ежедневно работают со множеством регламентов, ГОСТов и внутренних документов. Чтобы отвечать клиентам, готовить отчёты, проходить проверки, информацию приходится искать в нескольких системах и сверять с первоисточниками. На это может уходить до двух часов в день.
Сократить время поиска до нескольких минут помогают ИИ-решения на основе RAG. Большая языковая модель (LLM) подключается к корпоративным источникам и отвечает по ним на запросы пользователей.
Качество, скорость отклика и стоимость такого решения зависят не только от выбранной модели. На эти показатели влияют исходные данные, сложность запросов, архитектура, настройки поиска и проверяемость ответов.
В статье эксперт ИТ-компании KTS разбирает, всегда ли внедрение RAG экономически оправдано, как выбрать подходящую схему работы, оценивать качество ответов и сократить затраты на внедрение и эксплуатацию.
Какие задачи решает RAG и всегда ли он нужен
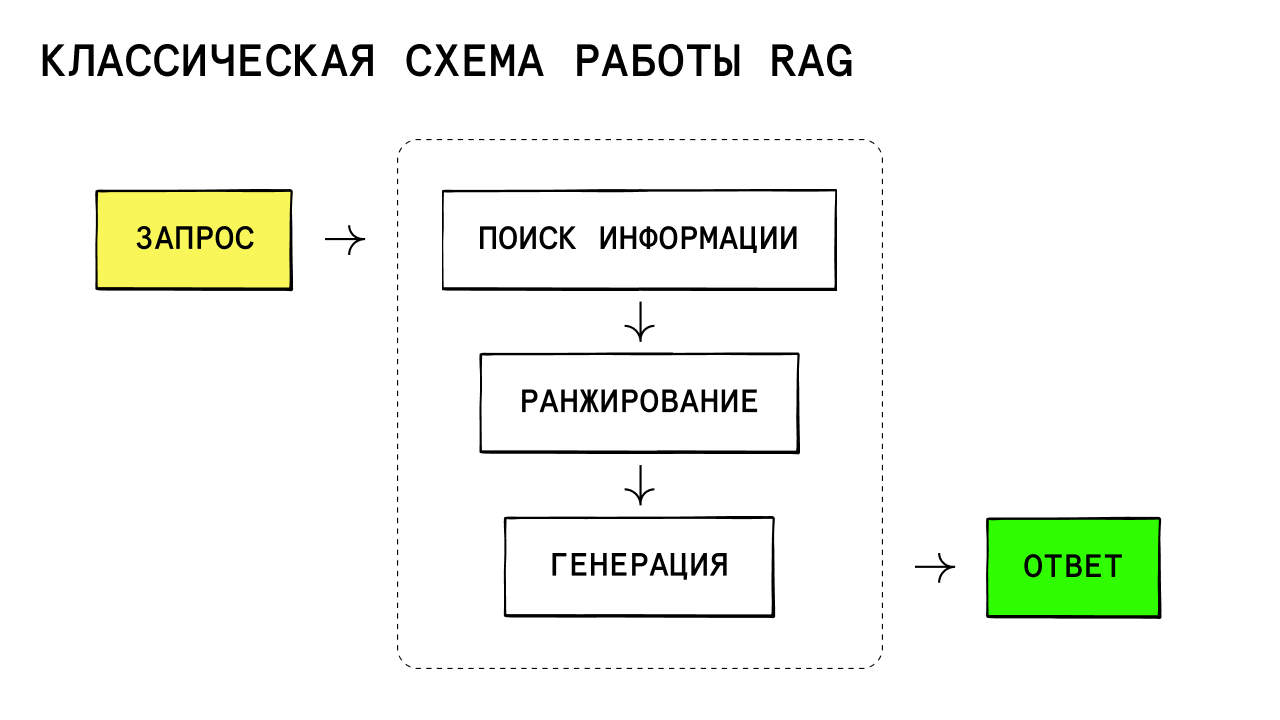
RAG (Retrieval-Augmented Generation) – подход, при котором большая языковая модель отвечает на запрос пользователя по внутренней базе знаний. Сначала система находит релевантные фрагменты документов, ранжирует их и передаёт контекст в модель. По этим данным она генерирует ответ и возвращает его пользователю.
Сегодня RAG – основа ИИ-агентов, которые работают с корпоративной информацией. У этого метода есть преимущества по сравнению с обычной генерацией, когда модель отвечает по исходному набору данных. Так компании, которые используют RAG, решают следующие задачи:
-
ускоряют работу с базами знаний;
-
снижают нагрузку на экспертов компании;
-
уменьшают человеческий фактор;
-
упрощают обновление и масштабирование.
Например, в совместном проекте KTS и Альфа-Банка RAG-платформа для операторов контакт-центра уменьшила среднее время обработки запроса на 13% и ускорила поиск данных в 20 раз. Инструмент получил 93% положительных оценок от специалистов поддержки, и его масштабировали на всех сотрудников банка.
Однако не всегда решения на основе RAG экономически оправданы. Например, когда у пользователей много типовых вопросов, внедрение RAG увеличивает стоимость и время обработки запроса без улучшения качества. Для таких задач больше подходит классификатор. Он определяет тему запроса даже при разных формулировках и по идентификатору (ID) находит подходящий вариант ответа.
Часто эффективнее применять гибридный подход: для типовых вопросов использовать шаблоны, а для нестандартных – поиск по базе знаний.
Схемы работы RAG-систем: как выбрать подходящую
Глобально RAG делят на классический и агентский. В обоих подходах система работает с каталогом данных, но по-разному управляет поиском и контекстом для генерации ответа.
Классический RAG – линейный однопроходный процесс: запрос → поиск → ответ. Такой метод лучше работает для простых вопросов, когда вся необходимая информация содержится в одном-двух фрагментах документов. Он легче и дешевле в разработке, тестировании и эксплуатации.
Классическую схему работы RAG-системы KTS использовали в проекте с ДВФУ и РАНХиГС. Компания обучила ИИ-ассистента для студентов на базе данных из 200 000 книг. Он помогает писать научные работы: по запросу пользователя готовит формулировки темы, структуру исследования, методические рекомендации и список литературы. Так решение от KTS сокращает время на сбор данных и анализ разрозненных источников.
В агентском RAG поиском управляет языковая модель: выбирает источник и инструмент, определяет количество циклов и при необходимости корректирует запрос и контекст. Этот подход более гибкий и адаптивный. Система может отвечать как на простые, так и на сложные аналитические запросы, для которых нужно объединить несколько фактов из разрозненных источников.
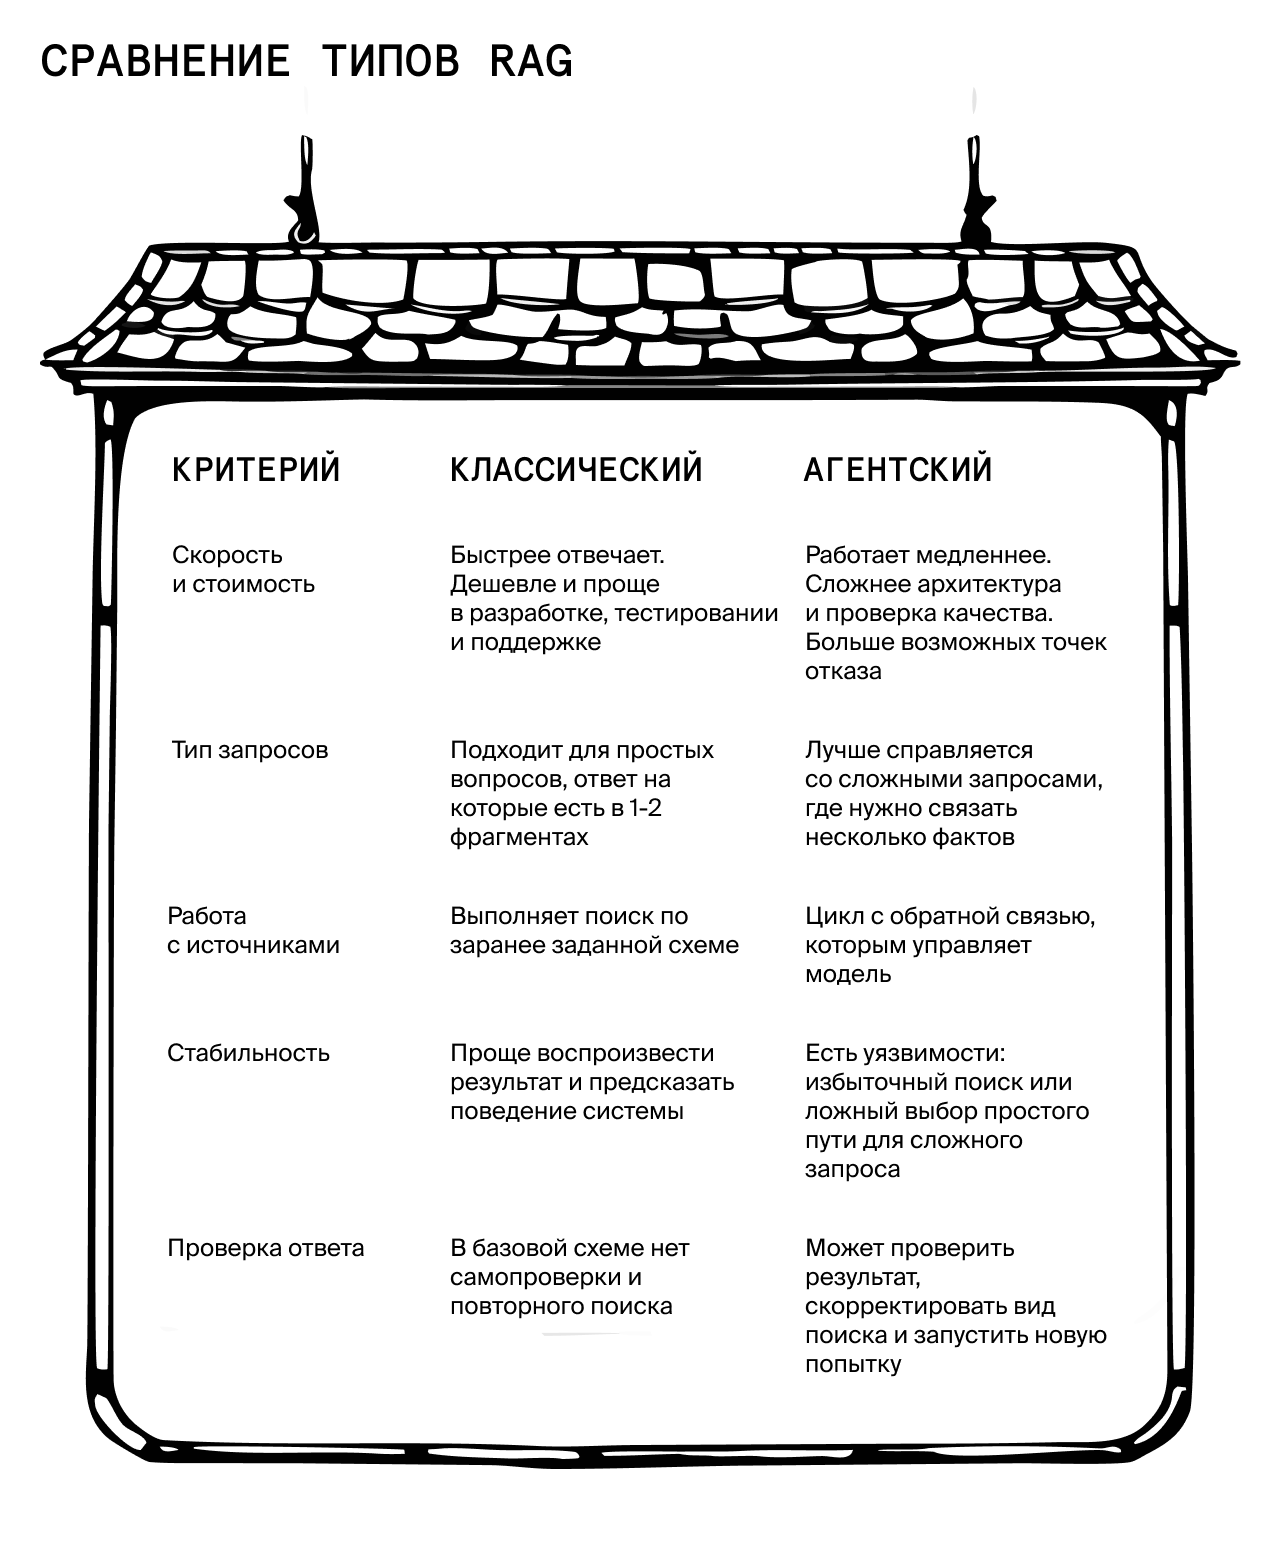
Начинать внедрение стоит с классического RAG, потому что это решение быстрее и дешевле. Если практика показывает, что уровень качества ответов недостаточный, можно добавить агентский RAG и распределять запросы.
«Обычно используют такую стратегию: в систему добавляют маршрутизатор, который направляет простые вопросы в классический RAG, а сложные – в агентский. Чаще всего это соотношение 80 и 20% соответственно. Это позволяет не запускать более дорогой агентский цикл без необходимости», – Екатерина Пославская, ML-разработчик KTS.
В основе любой схемы работы RAG три ключевых блока: индексация, поиск и генерация. Дальше подробно разбираем, что происходит в системе на каждом этапе.
Как устроена индексация в RAG
Сначала система извлекает из документов текст, таблицы и другие данные. Затем делит эти материалы на фрагменты (chunk), по которым будет искать информацию.
Для этого есть несколько способов. Самый простой – разбивать текст на фрагменты одинаковой длины. Если у документа есть естественная структура, дополнительно учитывают смысловые и структурные секции. Для сложных материалов, где смешаны текст, таблицы и изображения, можно использовать языковые модели. Но такая обработка увеличивает стоимость и продолжительность индексации.
Размер фрагмента зависит от содержания документов и запросов пользователей. Это всегда компромисс между точностью и полнотой контекста. Для коротких вопросов, например о расположении банкоматов или обновлении приложения, может быть достаточно 200 токенов. В рабочих системах обычно используют фрагменты размером 512–1024 токена, а для насыщенных информацией материалов, например юридических документов, – 1024–2048 токенов.
Соседние части обычно берут с пересечением 10% от их длины. Это помогает сохранить смысл на границе фрагментов.
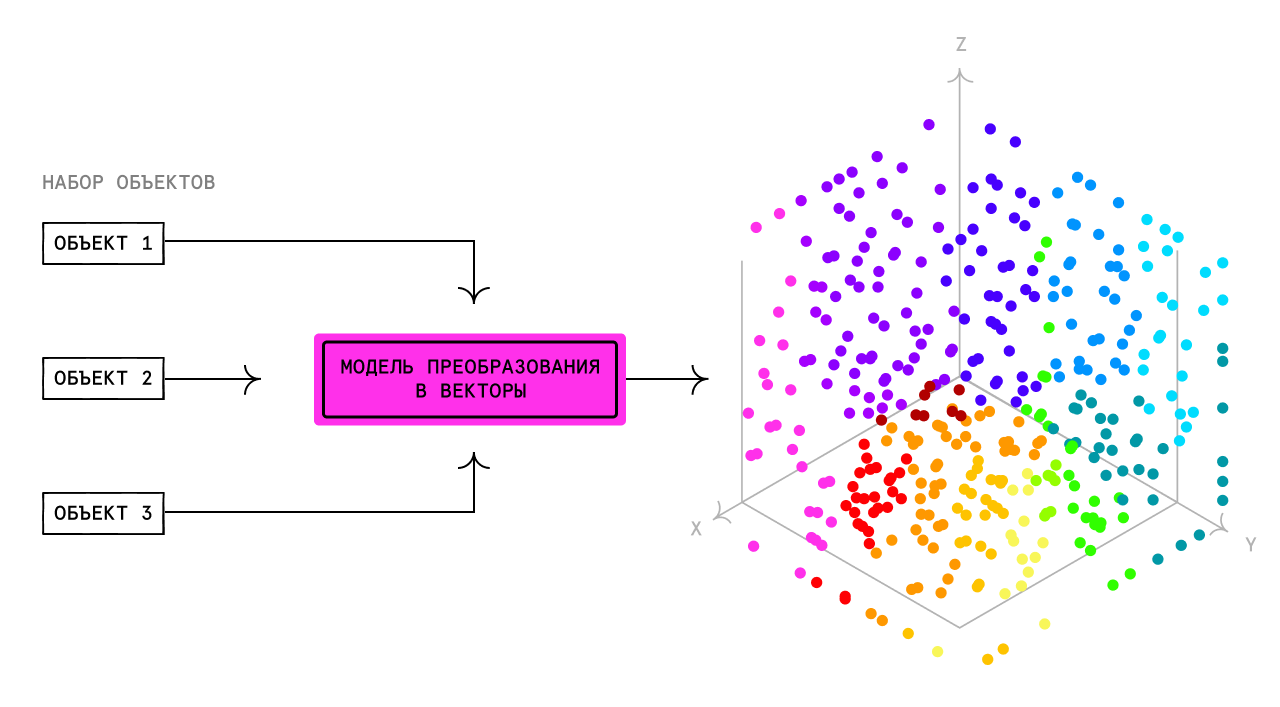
Далее система с помощью специальной модели (Embedding) преобразует фрагменты в векторы и сохраняет их в хранилище. Так формируется векторный индекс: упорядоченный каталог корпоративных данных.
Как работает поиск в RAG и какой подход выбрать
Когда пользователь задаёт вопрос, система обрабатывает его и обращается к индексу. Она находит релевантные фрагменты, ранжирует их и формирует топ-N – это контекст для языковой модели.
Алгоритм поиска определяется структурой индекса и задачей:
-
векторный находит фрагменты, близкие к запросу по смыслу;
-
полнотекстовый (BM25) ищет точные совпадения слов;
-
гибридный объединяет векторный и полнотекстовый поиск;
-
графовый учитывает сущности и связи между ними;
-
мультимодальный позволяет искать по текстам, таблицам, формулам и изображениям.
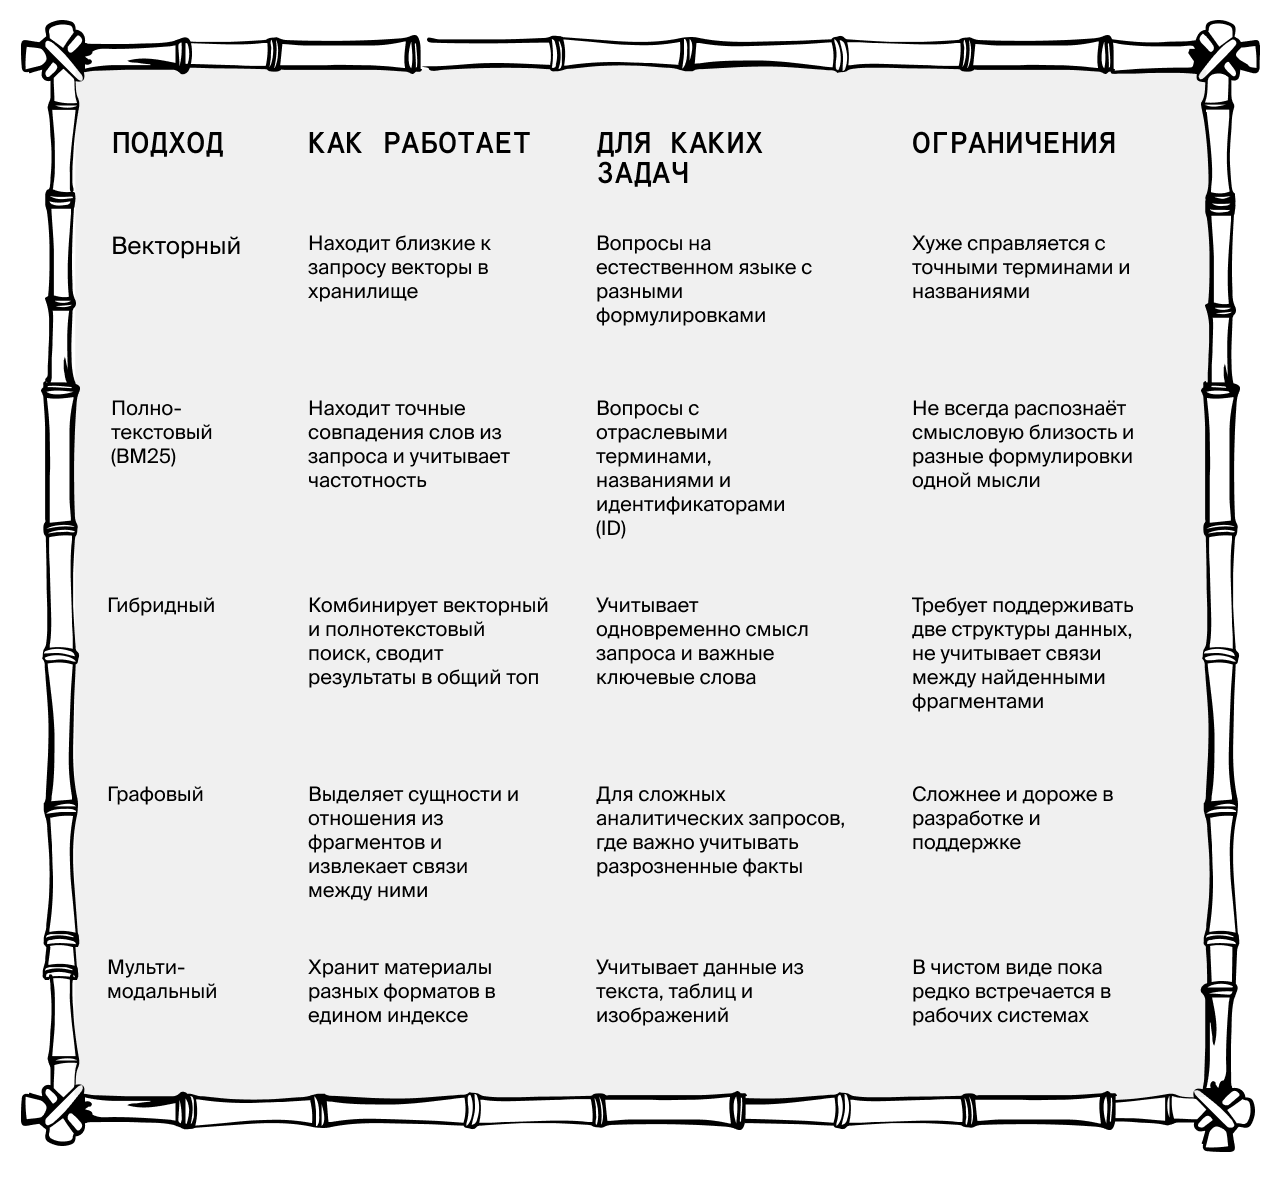
Лучше начинать с гибридного индекса – это оптимальный вариант по точности и стоимости. Графовый поиск стоит подключать, когда уровень качества ответов неудовлетворительный и тесты показали, что причина не в исходных данных.
«Графовый поиск может быть альтернативой агентскому RAG для сложных аналитических запросов. Например, когда в одной статье указаны условия кредита, а в другой есть информация о льготах. Он найдёт эту связь и объединит информацию.
Но создавать графовые базы сложнее и дольше. Появилась новая статья, и нам нужно перестроить весь граф. Это влияет на стоимость разработки и поддержки. Частые обновления обходятся дорого», – Екатерина Пославская, ML-разработчик KTS
Генерация: как управлять ответом языковой модели
После поиска система передаёт ИИ вопрос пользователя и набор релевантных фрагментов. На качество обработки этого контекста и генерации влияет системный промпт – инструкция, которая определяет поведение ИИ-агента.
Единого шаблона промпта для языковой модели нет. Можно начать с такой структуры и, если нужно, доработать её под ваши цели:
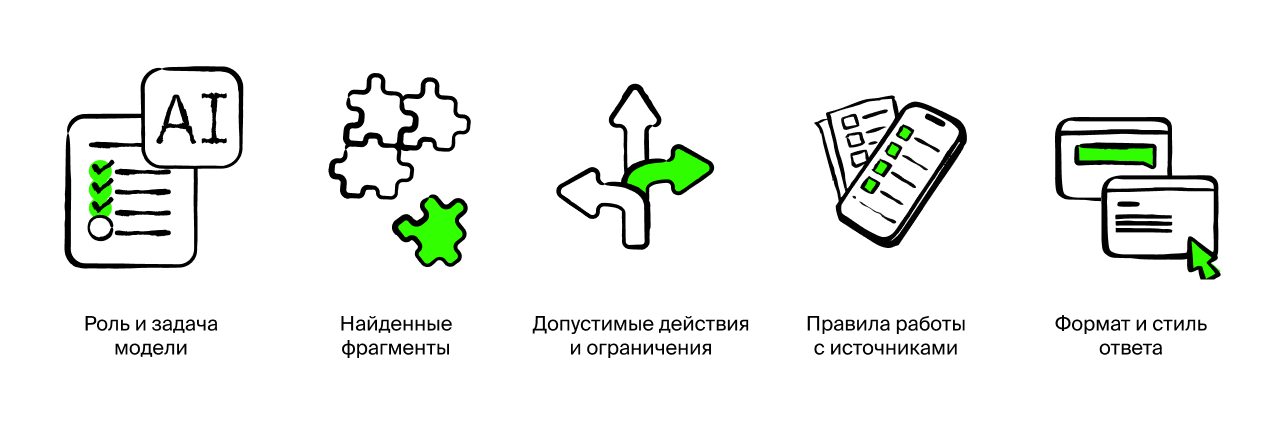
Например, в системном промпте можно запретить модели использовать информацию вне контекста, попросить сообщать о нехватке данных и добавлять ссылку на источник после каждого утверждения.
На результат также влияют параметры генерации:
-
Температура (temperature): определяет вариативность ответа. Для фактологических задач обычно устанавливают значение от 0 до 0,3, чтобы результаты были более предсказуемыми.
-
Максимальное количество токенов: ограничение, которое помогает контролировать расходы на генерацию.
-
Принудительное цитирование (citation enforcement): требует, чтобы модель подтверждала информацию ссылками на источники и приводила цитаты при необходимости.
Дополнительно можно проверять ответы с помощью языковой модели, которая выступает в роли судьи. Она оценивает черновик, созданный ИИ, на соответствие найденному контексту (faithfulness). Это помогает обнаружить утверждения, которых не было в переданных фрагментах, и снизить риск галлюцинаций.
Как оценивать качество RAG-системы: практический подход
В академической среде работу RAG оценивают по множеству показателей: релевантности ответа, частоте галлюцинаций, времени и стоимости обработки запроса, количеству циклов и другим. Однако для расчёта этих метрик нужен размеченный набор данных с эталонными ответами. Это требует значительных затрат со стороны экспертов заказчика.
На практике оценку качества RAG упрощают и ускоряют. Для этого используют связку модель-судья + экспертная валидация и проходят несколько этапов.
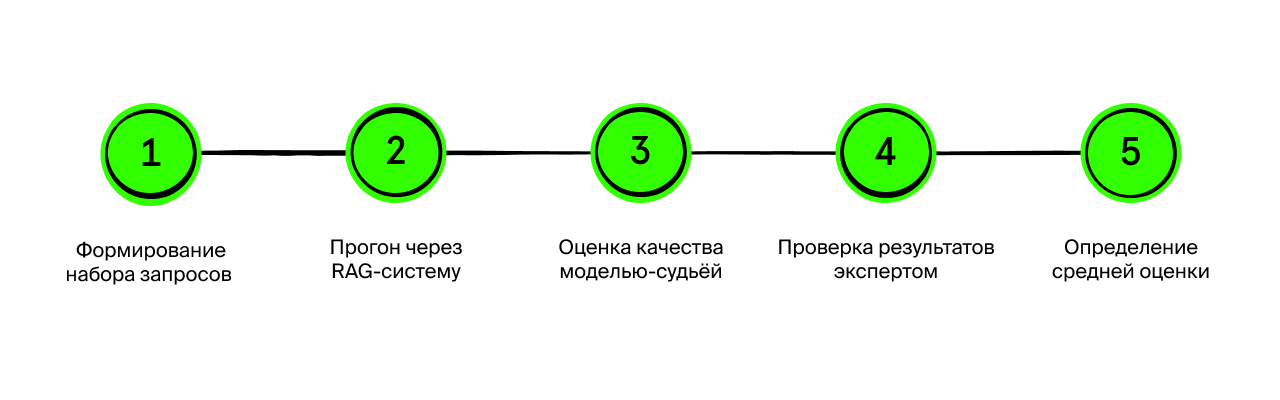
1. Собирают репрезентативный набор запросов. Обычно достаточно 50–200 типовых вопросов и ответов. Например, реальные обращения из службы поддержки или отдела по работе с персоналом.
2. Прогоняют набор через RAG-систему. Сохраняют найденные фрагменты, ссылки на источники и ответы модели. Эти данные понадобятся для проверки.
3. Оценивают качество ответов. Модель-судья проверяет результаты по заранее заданным критериям. Например, таким:
-
правильно ли система ответила по существу (correctness);
-
полностью ли раскрыла вопрос (completeness);
-
насколько опирается на предоставленный контекст без фантазий (groundedness);
-
много ли «воды» в ответе (conciseness);
-
качество цитирования (citation quality).
Обычно для оценки используют бинарную шкалу «хорошо – плохо». Но опыт KTS показывает, что лучше выставлять баллы от 1 до 10. Это позволяет анализировать качество ответов по разным критериям и помогает понять, где есть узкие места.
4. Эксперт проверяет результаты. Перед вводом в эксплуатацию специалист заказчика оценивает всю выборку и правит ответы. Это занимает намного меньше времени, чем составление эталонного набора данных с нуля.
5. Определяют среднюю оценку. Ответы языковой модели могут различаться даже при одинаковом запросе, поэтому одного прогона недостаточно. Чем меньше тестовая выборка, тем больше нужно повторов. Например, набор из 50 вопросов лучше прогнать не менее пяти раз, рассчитать среднюю оценку и оценить динамику.
На этапе эксплуатации продолжают следить за уровнем качества работы RAG-системы. Эксперт вручную проверяет 10–20% выборки. Например, разбирает сложные кейсы или случаи, когда модель-судья поставила от 4 до 6 баллов. Специалист определяет причины низких оценок, и команда разработки устраняет недостатки.
«Иногда компании используют пользовательское голосование. Но я не рекомендую таким способом оценивать качество ответов. У нас нет контекста, мы не знаем, почему пользователь нажал единицу. Может, случайно или у него настроение плохое. Поэтому лучше использовать для оценки качества только экспертную валидацию», – Екатерина Пославская, ML-разработчик KTS
5 реальных проблем RAG-систем и как их исправить
Собрали основные сложности, с которыми компании сталкиваются после запуска:
1. Качество системы деградирует со временем. Основная причина – данные: по мере роста в базе знаний остаются устаревшие документы, появляются дубли, противоречия и двойственные условия. Чем больше такого шума, тем сложнее подобрать релевантные фрагменты.
Чтобы поддерживать качество, нужна гигиена данных. Раньше такая работа требовала значительных ресурсов со стороны заказчика. Сейчас часть процесса можно автоматизировать с помощью ИИ. Например, мы в KTS используем специальный модуль проверки (Data Validator): он находит дубли и возможные противоречия в базе знаний. Эксперт оценивает результаты проверки и решает, какие данные нужно исправить, объединить или удалить.
Другие причины деградации качества – изменение способа обработки документов, размера фрагментов, модели для преобразования в векторы, аудитории или актуальных для неё тем. Поэтому проводят гигиену индекса и используют версионирование компонентов. Также после обновления систему прогоняют на эталонном наборе данных и проверяют, не ухудшились ли результаты.
2. Низкое качество ответов. Сначала проверяют, попал ли нужный факт в найденные фрагменты. Если нет, проблема в поиске. Чтобы её исправить, расширяют и структурируют запрос, меняют параметры ранжирования и делят базу на тематические разделы.
Если дело не в поиске, дорабатывают генерацию: промпт, температуру, правила цитирования и самопроверку.
3. Медленные и дорогие ответы. Снизить затраты помогают сохранение одинаковых и похожих запросов, маршрутизация вопросов и оптимизация контекста. Например, можно уменьшить количество фрагментов в топ-N или разбить слишком крупные, чтобы модель не получала лишние данные.
4. Галлюцинации и вымышленные цитаты. Сегодня большие языковые модели стали значительно умнее, поэтому чаще проблема в исходных данных. Например, ИИ-ассистент отвечает по реальному документу, но в нём есть опечатка или неактуальная информация.
Если проблема не в данных, используют строгий промпт, добавляют требование предоставить ссылки на источники и проверку ответа. В критичных сценариях результаты дополнительно оценивает эксперт.
5. В ответах смешиваются данные из разных предметных областей. Например, для ответа на кадровый вопрос система использует документы финансового отдела. Чтобы этого избежать, базу делят на домены и создают для каждой свой индекс. Также помогает фильтрация документов по метаданным. В результате уменьшается контекст, повышается скорость работы и точность ответа.
* RAG (Retrieval-Augmented Generation) – технология, при которой искусственный интеллект ищет информацию в подключённых источниках и формирует на её основе ответ.

